Git 是 Agent 最好的记忆
Agent 上周学会的 API,这周又要重新学——每个新服务都是冷启动。我的答案不是向量数据库,而是一个 helpers 目录加 git 历史。
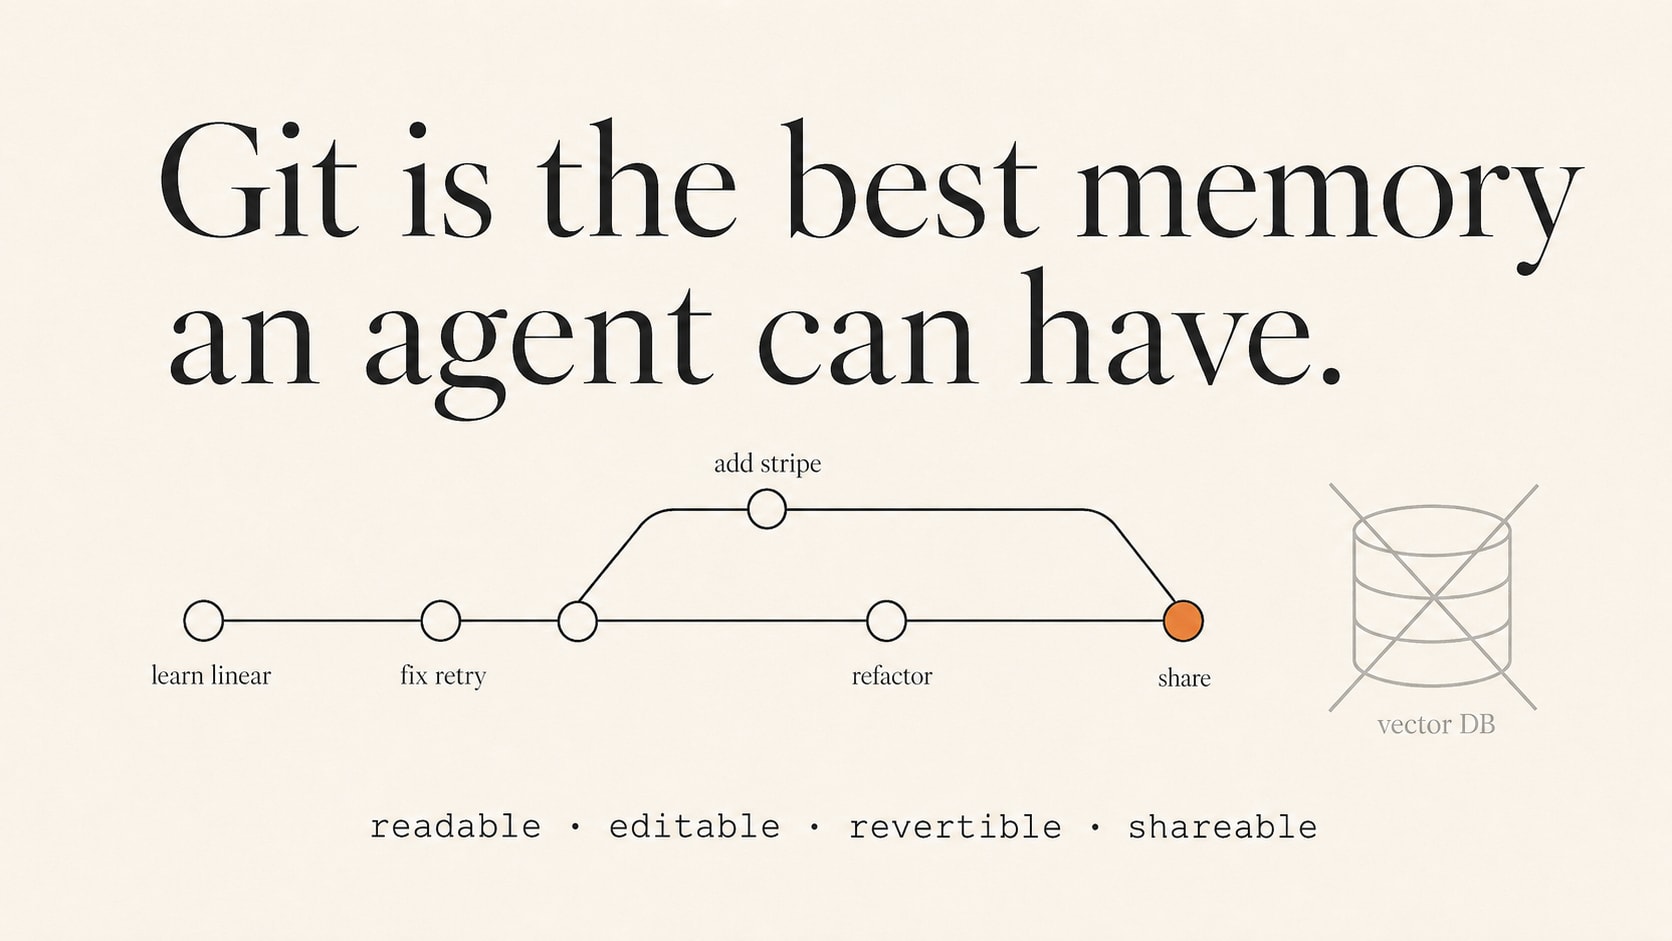
做 agent 工具的人都遇到过同一件尴尬事:你的 agent 上周刚学会调 Linear 的 API——读文档、试错、跑通——这周再遇到 Linear,它又从零开始读文档、试错、跑通。没有肌肉记忆,每个新服务都是冷启动。
行业的标准答案是给 agent 接一个向量数据库,把「经验」嵌入成向量存起来。我做开源项目 graft 时选了另一条路,理由是一个朴素的观察:
工程师积累经验的方式,从来就是写代码、存进 git。
为什么 agent 要例外?
于是 graft 的记忆设计只有两层:一个 helpers 目录——agent 边干活边写、边修订的代码文件,每个 service 一个;加上 git 历史。这套组合拳的好处,向量数据库一个都给不了:
- 可读 —— 人随时能打开看 agent 学到了什么,错的当场就能发现;
- 可改 —— agent 自己重构自己的经验,人也能直接修;
- 可回滚 —— 学坏了?git revert;
- 可分享 —— push 到一个纯 git 的社区注册表,别人的 agent 直接复用,不需要任何中心服务器。
这背后是 Browser-Use 团队说的 agent harness 的 Bitter Lesson:不要教 agent 怎么干活,要给它一块自己维护的自留地。模型每年都在变强,你写死的「教学逻辑」会迅速过时;但「让它自己积累、自己修订」的机制不会。
graft 还有一条更激进的纪律:核心代码的行数由 CI 强制预算,bug fix 不允许增加行数——如果修一个 bug 要加代码,大概率说明没找到根因。行数不是成本指标,是设计质量的体温计。
记忆放进 git 还有一个隐藏的好处:它强迫经验「成文」。向量库里的嵌入是黑盒,没人 review 得了;而一个 80 行的 helper 文件,人和 agent 都能 review、能测试、能信任。
信任不是喂出来的,是审计出来的。这句话对人成立,对 agent 同样成立。