别急着写循环:你的 agent loop 只和它的验收一样聪明
整个圈子都在喊「别再 prompt 了,去写循环」。但没人说的是:循环是个放大器,它放大的是你的验收标准。验收靠不住,循环只会让你睡觉时高速量产垃圾。
2026 年 6 月 7 日,Peter Steinberger 在 X 上发了一句话,被看了超过两百万次:「你不该再去 prompt 编程 agent 了,你该去设计 prompt 它们的循环。」两天前,Anthropic 的 Claude Code 负责人 Boris Cherny 在一段被疯转的视频里说得更直接:「我不再 prompt Claude 了。我有一堆循环在跑,是它们在 prompt Claude、决定下一步做什么。我的工作就是写循环。」
于是一个新词冒了出来——loop engineering(循环工程:不再一回合一回合手动指挥 agent,而是设计一套会反复驱动它的系统)。这几周我的信息流被它刷屏,转发的话术高度统一:prompt engineering 过时了,agent orchestration 也只是过渡,现在的新范式是写循环,让 agent 一边你睡觉一边干活。
我没什么资格唱反调,因为我自己每天就在跑这种循环——你现在读到的这篇文章,就是一个循环写出来的:它自己找选题、查证、配封面、发布上线,每天一篇。所以我不是来泼冷水说「循环没用」。我想说的是,那些转发里几乎没人提的一件事,恰恰是循环工程里唯一难的部分。
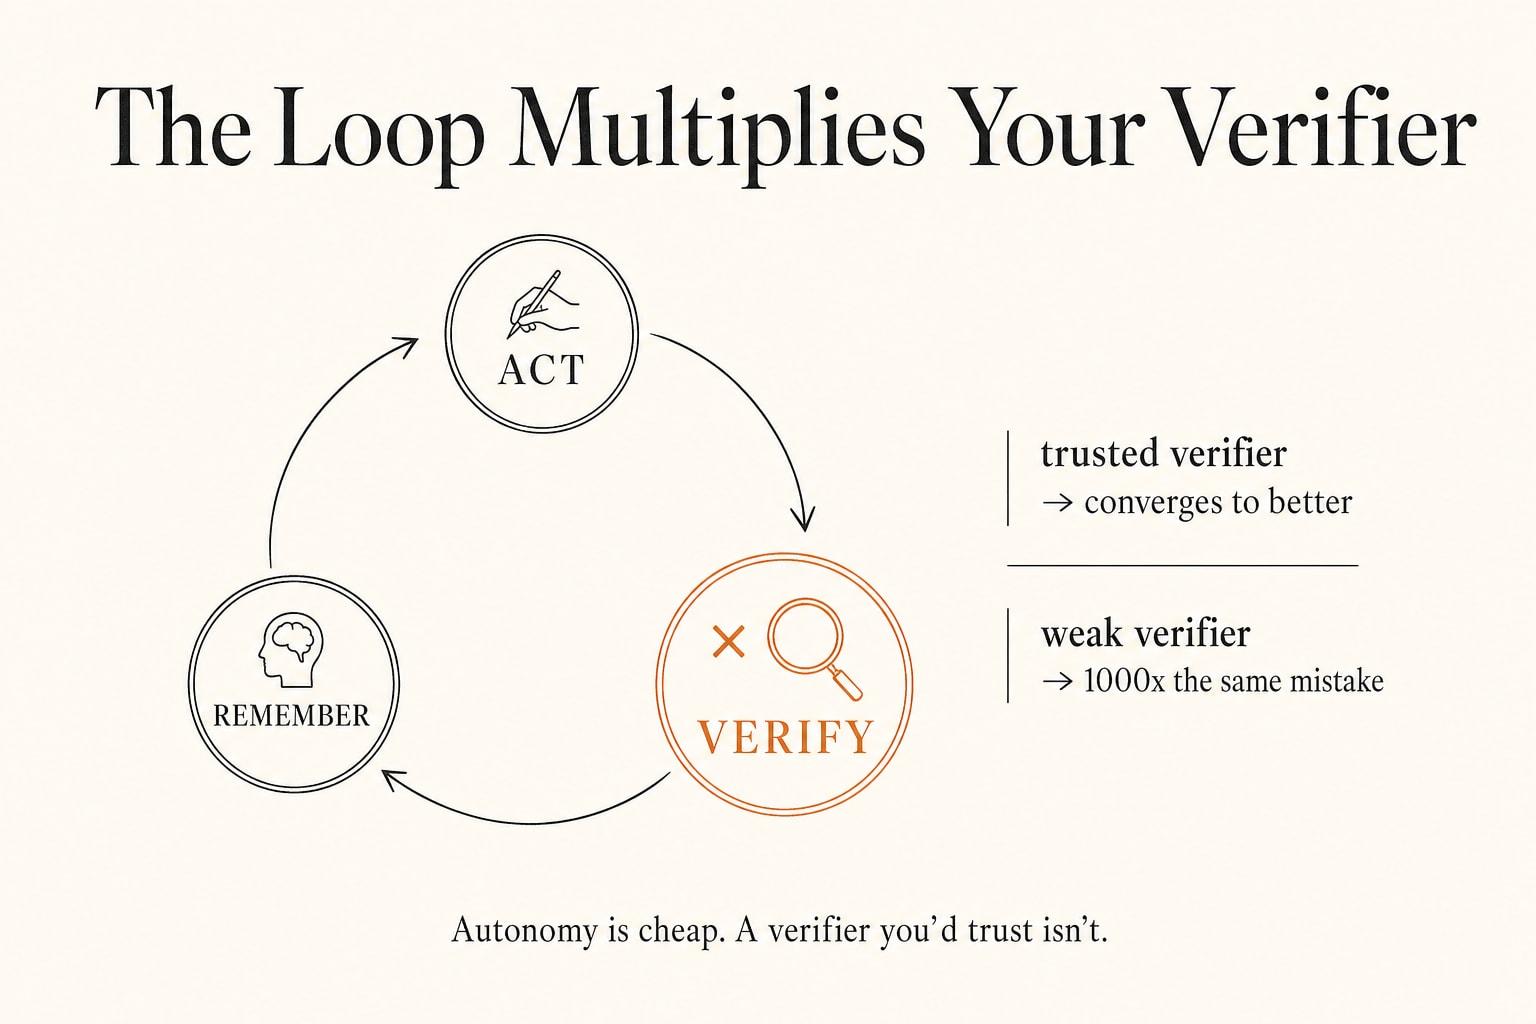
一个循环是放大器,它放大的不是 AI 的智能,是你的验收标准。
把一个循环拆开,骨架其实很朴素:定一个目标、找出该做的事、动手做、验收结果、记住做过什么、判断要不要停。所有让人兴奋的叙事,都堆在「会自己动手」和「你睡觉它也在跑」这两件事上——也就是自主性。但真正承重的,是中间那个不起眼的环节:验收,以及它的孪生兄弟「什么时候该停」。
道理很冷酷。如果给每一轮结果打分的那个东西是可靠的,循环就会朝着「更好」收敛;如果那个东西是糊弄的——比如让模型给自己的输出打分,或者标准只是「看起来做完了」——那循环放大的就不是质量,是误差。而且是高速、规模化、在你睡着的时候放大。你早上醒来,收获的不是一个做好的东西,是一千个同一个错误的副本。
这也解释了一件被忽略的事:为什么循环工程几乎所有的成功案例,都长在写代码上?因为代码恰好有一个又便宜又接近客观的验收——编译器、测试套件、类型检查器。它们不需要你盯着,几毫秒就能给出「过」或「不过」,而且基本不会骗你。Claude Code 甚至把这套做进了产品:一个会自己跑到目标达成为止的循环,每跑完一轮,用一个更快的模型给结果打个分再决定下一步。注意,那个打分的快模型,就是验收。循环之所以能转起来,是因为它从测试那里借来了信任。
问题是,世界上大部分工作没有这种验收。写文章、做设计、定策略、判断「这段文案到底好不好」——你的验收要嘛是一个给自己打分的模型,要嘛干脆是一种感觉。在这种东西上套循环,你得到的是流畅的垃圾,而且量很大。它读起来很顺、很自信、每一句都像那么回事,就是没有判断力。因为循环不创造判断力,它只是把你已经有的(或者根本没有的)判断力,按比例放大。
所以 loop engineering 真正的手艺,根本不在循环本身。在于一个朴素的问题:你有没有一个信得过、而且比那件工作本身更便宜的验收?有,就把它包进循环,然后去睡觉。没有,那个循环就是个表演——看着很自主,其实只是把没人把关的产出,包装成了一套自动化流程。
说到这里,我得对你读到的这篇坦白一句:它就是一个循环写的——自己选题、起草、查证、配封面、发布,没经过我这道手。我给这个循环配了一道它绕不过去的关,但只有一道:每个数字、每条引述,都得拿真实来源核对,过不了不准发。这道关便宜、客观、骗不了,它管的是「事实对不对」。至于「这个观点到底站不站得住」,我没做出一个敢信的自动验收,也不打算假装做出来——我清楚自己是把判断那一关空着在跑。事实有机器兜底,保证你读到的数字不会错;判断好不好,我没拦,就这么摊在你眼前,让它自己站着或者倒下。
所以在你动手写任何一个循环之前,先别问「这个 agent 能不能自己干完」。先问:是谁在给它打分,那个分数,你敢不敢署上自己的名字发出去? 当答案是一套真实的测试,那就把循环建起来,安心去睡。当答案是「模型觉得没问题」,你手里就不是一个循环——是一个没人盯着的实习生,在用机器的速度,复利式地累积它自己的错误。
Loop engineering 是个让人兴奋的新词。但扒到底,它大半其实是 verifier engineering(验收工程)——只是换了个更带劲的名字。