你在比的那一层,根本不重要
Hacker News 吵着「本地模型能不能替掉 Claude 写代码」,四百多条没人质疑前提。决定能不能换的从来不是模型够不够好,是包在模型外面那层 harness。
这几天 Hacker News 首页挂着一个问题,一千多个赞、四百多条回复:「有人真的拿本地模型替掉 Claude / GPT 来日常写代码了吗?」底下吵成一团。一派说本地省钱、私密、断网也能跑,有人算过两张 RTX 3090,三四年就把云端订阅的钱赚回来;一派说本地还是差一截,关键时候得爬回云端。
吵了四百多条,没人质疑问题本身。这个问题里埋着一个假设:决定「能不能换」的,是模型够不够好。 好像只要本地模型的分数追上来,这事就成了。我每天靠 agent 写代码,判断正好相反——大多数人盯错了那一层。
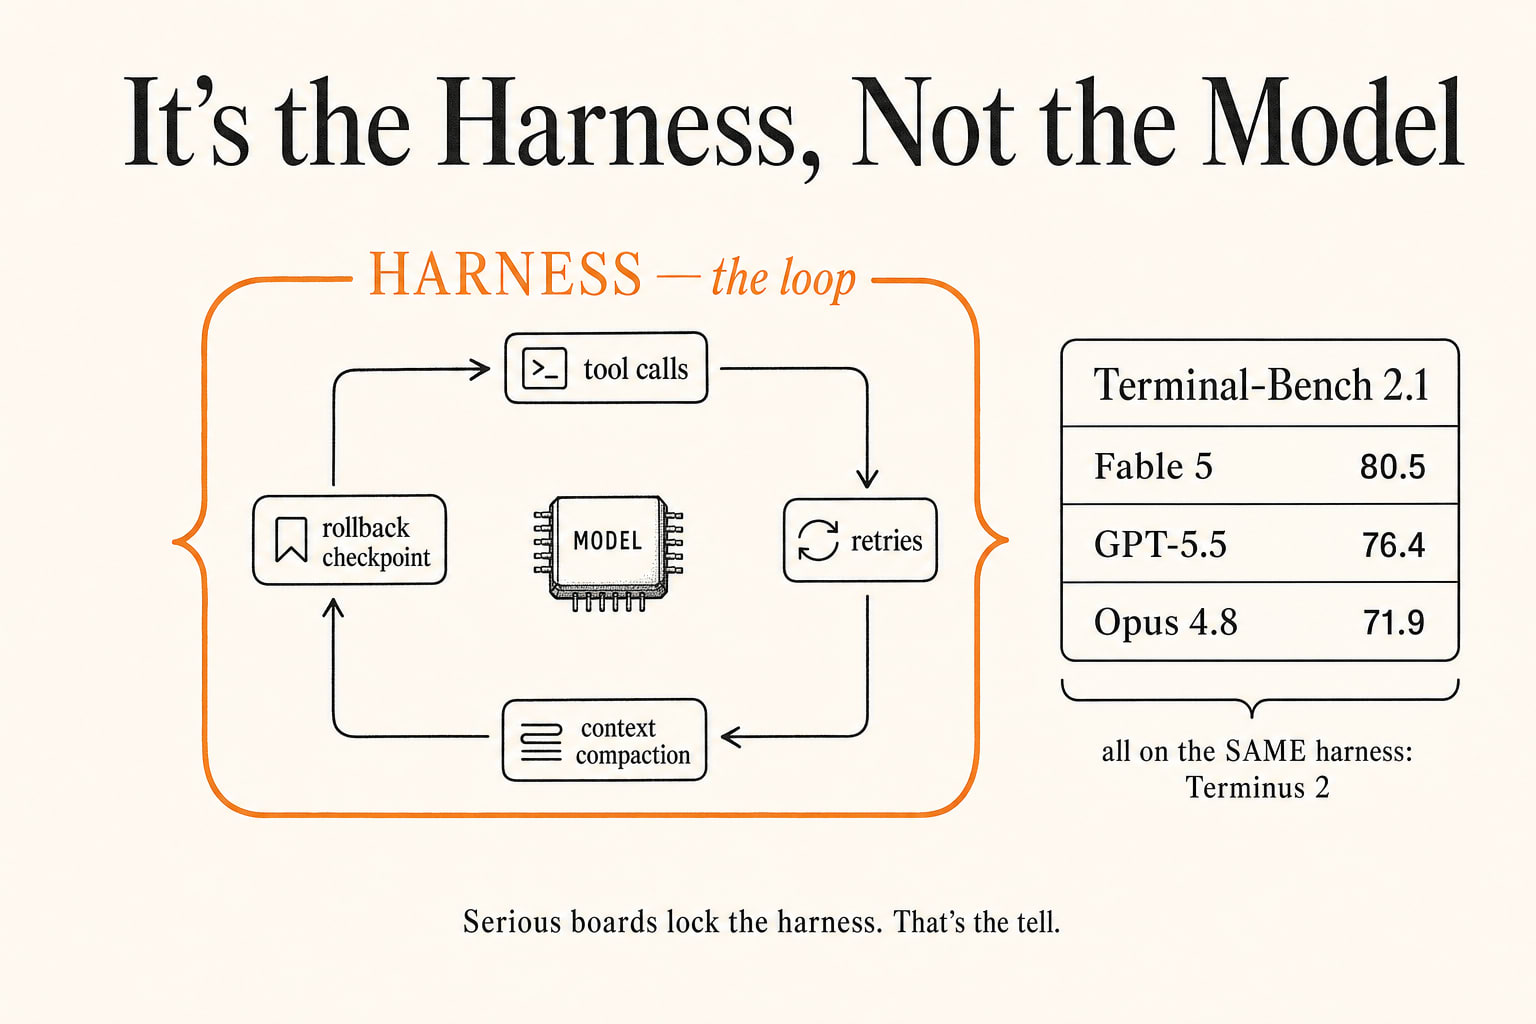
agent 写代码,从来不是「模型吐出一段代码」这么简单。它是一个循环:读仓库、调工具、改文件、跑测试、看报错、再改、再跑。一个真实任务下来,几十上百次工具调用,模型只是这个循环里被反复调用的那个零件。真正决定这一长串会不会跑通、会不会在第 30 步把自己绕晕的,是包在模型外面那层东西——业内叫它 harness(脚手架:把模型接进工具、管上下文、处理重试和验证的那套程序,Claude Code、Codex CLI 都是 harness)。
最干净的证据,藏在 benchmark 自己的设计里。Terminal-Bench 2.1(测 agent 在真实终端里干活的榜单)这一版,Fable 5 以 80.52 分居首,GPT-5.5 76.40,Opus 4.8 71.91。但真正值得看的不是名次,是方法说明里那句:所有模型,都用同一个叫 Terminus 2 的 harness 来测。 为什么要锁死 harness?因为榜单的设计者清楚,harness 是个能把模型差距淹掉的干扰项——不固定住它,你测出来的根本不是谁的模型强,是谁的壳更好。「严肃榜单必须锁死 harness」这件事本身,就是 harness 和模型同等重要的铁证。
这在日常里更明显。SWE-Bench 那种榜单测的是「给一道封装好的题,模型能不能解」——模型在真空里的智力。可你真正的工作不是解一道题,是在一个你没读过的二十万行仓库里,改一处不碰坏另外三处,连着几个小时不丢上下文。这些榜单一个都没测。HN 那条帖子里,用本地模型的人反复说的也不是「它不会写函数」——一个 30B 的本地模型,写单个函数早就够了。他们说的是:它像个需要你手把手带的初级工程师,你得把架构给它指明、把任务切到最碎、连调试语句都得自己记得删。这些全是「连续几十步不走样」的毛病,是循环的毛病,不是智商的毛病。 而没有好 harness 兜着,前沿模型一样会在半路走样。
想清楚这一层,本地 vs 云端就换了个问法。harness 干的全是不起眼的脏活——把模型输出准确落进文件、报错了自动重试、上下文要爆了及时压缩、每改一步留个能回退的存档。这层恰恰是开放的、你自己能动手改的。我在自己的 agent 里换底层模型,输出常常没什么变化;可那次我重写了验证那一步——让它每改完必须自己跑一遍、不过就回滚——整个系统的可用度肉眼可见地往上跳。模型在变成水电,harness 才是你真正能攥在手里的杠杆。
所以那个 HN 问题,我会换成一句话来答:别问本地模型够不够格替掉 Claude,先问你那个循环够不够稳——稳到换哪个模型进去都照跑。harness 糙,再强的云端模型也只是帮你把翻车点往后挪几步;harness 稳,本地模型能接管的那天,会比榜单告诉你的来得早。
值得换的从来不是模型,是你包在它外面那层东西。